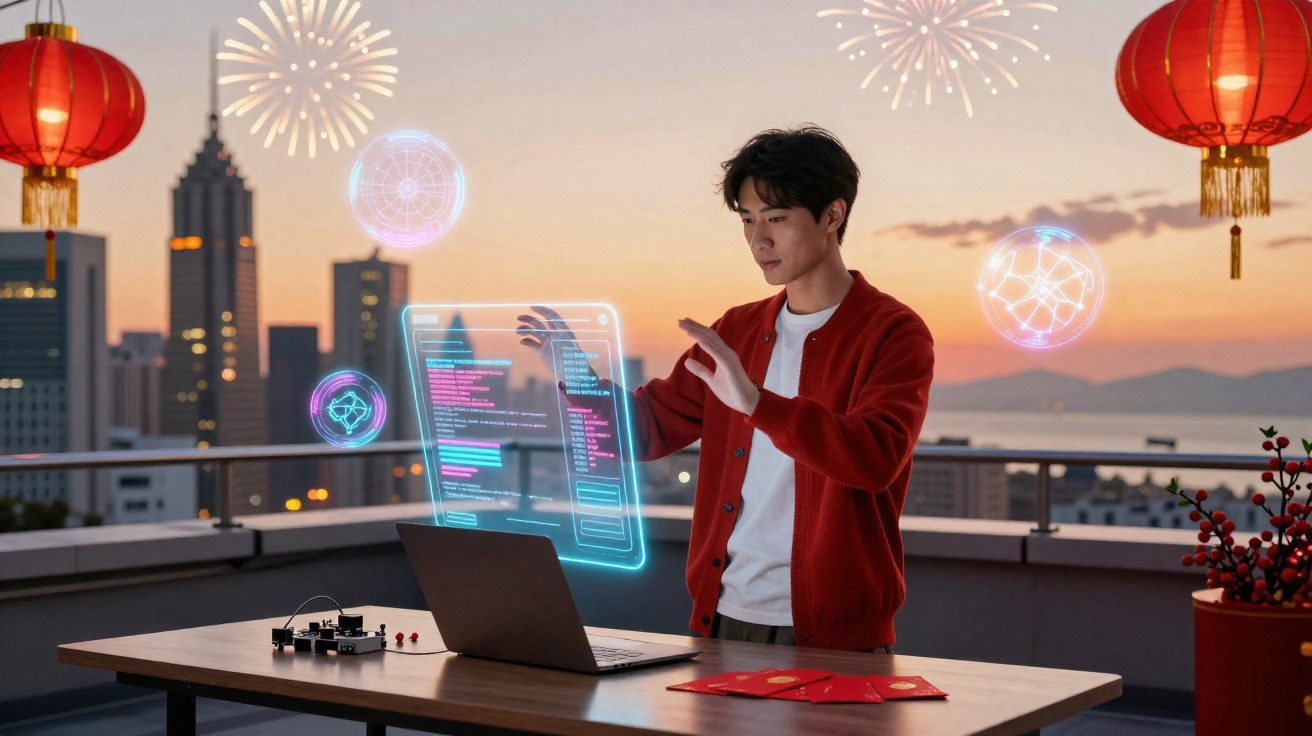
A China transforma o Ano Novo Lunar numa montra para o seu avanço tecnológico: novos modelos de inteligência artificial desafiam diretamente a liderança da Califórnia.
Enquanto os dragões dançam na China e o fogo de artifício ilumina o céu, as grandes tecnológicas lançam o seu próprio espetáculo digital. Os novos modelos de IA vindos de Pequim, Hangzhou e Shenzhen aproximam-se tanto do ChatGPT, do Gemini e de outros concorrentes que até Sam Altman, líder da OpenAI, começa a refletir. Surge assim uma pergunta: durante quanto tempo continuará Silicon Valley a dominar a inteligência artificial?
A China faz do Ano Novo uma montra de IA
As celebrações do Ano Novo Chinês não se limitaram às tradições: também deram palco à tecnologia avançada. Em espetáculos oficiais, robôs humanoides dançaram em sincronia com pessoas. As coreografias transmitiam uma mensagem simbólica: a China quer mostrar que deixou de ficar para trás na robótica e na inteligência artificial.
Ao mesmo tempo, os principais grupos tecnológicos chineses lançaram uma nova geração de modelos de IA. A oferta cobre praticamente todas as áreas relevantes do desenvolvimento atual, desde geradores de vídeo e assistentes de conversação multimodais até ferramentas de programação altamente especializadas.
Os Estados Unidos procuraram travar a China com proibições à exportação de chips, mas essa mesma pressão está a obrigar as empresas chinesas a alcançar uma eficiência radical, com efeitos visíveis na rapidez e nos custos.
Numa entrevista à CNBC, Sam Altman reconheceu abertamente o ritmo «notável» da China. O elogio tão explícito de um gestor de topo norte-americano mostra a seriedade com que Silicon Valley encara os novos concorrentes.
O embargo dos EUA como impulso inesperado
Na origem desta evolução está, precisamente, a política norte-americana. Washington impõe fortes restrições à exportação de chips avançados de IA para a República Popular da China. A intenção era abrandar os planos chineses, mas, na prática, sucede muitas vezes o inverso.
Enquanto empresas como a OpenAI, a Google e a Meta constroem enormes centros de dados equipados com chips da Nvidia, os programadores chineses têm de trabalhar com recursos muito mais limitados. Essa escassez obriga-os a procurar novas soluções: arquiteturas económicas, métodos de treino otimizados e alternativas ao hardware norte-americano.
Um exemplo é a utilização dos chips Huawei Ascend em grandes modelos de linguagem. Estes semicondutores não são provenientes dos EUA, mas já têm capacidade suficiente para treinar modelos de topo. Trabalhar com eficiência nessas condições reduz os custos de forma duradoura, criando uma vantagem estratégica na concorrência mundial.
Modelos abertos como trunfo: a aposta da China no código aberto
Há uma característica que favorece muitos utilizadores europeus: uma grande parte dos novos modelos chineses é disponibilizada em versões de código aberto ou com pesos abertos.
- Código aberto: o código-fonte e a arquitetura do modelo são públicos, tal como frequentemente acontece com os dados de treino.
- Pesos abertos: os pesos do modelo podem ser descarregados, embora o código subjacente seja parcialmente proprietário.
As duas abordagens partilham uma vantagem: os modelos podem funcionar localmente, em servidores próprios ou até em estações de trabalho potentes. Deste modo, as empresas mantêm o controlo total dos seus dados, sem os enviar para plataformas norte-americanas ou fornecedores chineses de serviços na nuvem.
Para muitas empresas alemãs, a proteção de dados é o fator decisivo: um modelo potente que funcione inteiramente no centro de dados da própria empresa pode tornar-se mais atrativo do que um sistema norte-americano ligeiramente melhor alojado na nuvem.
É precisamente nesse ponto que muitos fornecedores chineses concentram a sua aposta. Aliam um desempenho elevado à possibilidade de descarregar, adaptar e proteger o modelo internamente. Para as comunidades de programadores, isso é uma dádiva; para as empresas norte-americanas, representa uma ameaça ao negócio de licenças e interfaces de programação de aplicações (API).
Vídeos impressionantes: o Seedance 2.0 inquieta Hollywood
Entre as novidades do Ano Novo, o modelo de vídeo Seedance 2.0, da ByteDance, empresa proprietária do TikTok, recebeu especial atenção. Os vídeos gerados parecem pequenas cenas de cinema, com movimentos de câmara elaborados e personagens convincentes, ficando claramente mais próximos da qualidade cinematográfica do que as soluções anteriores.
O Seedance 2.0 distingue-se da restante vaga chinesa por não estar disponível de forma aberta. Não é possível descarregar o código nem os pesos: continua a ser um produto proprietário convencional. Apesar disso, já está a gerar polémica. A Disney, a Paramount e a Netflix acusam a ByteDance de possíveis violações de direitos de autor. Suspeita-se que o modelo possa assentar fortemente em material cinematográfico protegido.
Para o setor, trata-se de um sinal de alerta. À medida que os vídeos gerados se tornam mais realistas, estúdios, realizadores e sindicatos questionam com maior insistência a utilização justa dos dados de treino, a proteção dos universos associados às marcas e a eventual perda de empregos. Ainda assim, o Seedance 2.0 mostra claramente que a China compete entre os líderes da IA aplicada ao vídeo.
Qwen, GLM, DeepSeek e Kimi: a nova armada de IA da China
Qwen3.5: o modelo multimodal versátil da Alibaba
Com o Qwen3.5, a Alibaba aposta num grande modelo de visão e linguagem capaz de compreender e relacionar texto, imagens e vídeos. O assistente de conversação reconhece conteúdos em cerca de 200 línguas e pode atuar como «agente» em formulários, páginas Web ou ferramentas internas, por exemplo para automatizar fluxos de trabalho.
O Qwen3.5 está disponível com uma licença livre em plataformas como o GitHub. Os programadores podem integrá-lo nos seus próprios produtos, ajustá-lo ou executá-lo na sua infraestrutura. Para a Alibaba, esta é também uma forma de ligar ecossistemas globais de IA aos seus serviços na nuvem.
GLM-5 da Zhipu AI: otimizado para agentes e raciocínio complexo
Apresentado pela Zhipu AI, o GLM-5 destina-se sobretudo a programadores e empresas interessados em criar agentes de IA autónomos. Segundo a empresa, o modelo privilegia o raciocínio lógico em várias etapas, o planeamento rigoroso e a resolução robusta de problemas.
Do ponto de vista técnico, destaca-se a utilização da «DeepSeek Sparse Attention» (DSA), ou atenção esparsa da DeepSeek. Esta técnica limita seletivamente a atenção do modelo às partes relevantes do contexto. Assim, reduz-se o esforço computacional sem uma perda acentuada de qualidade. O GLM-5 foi treinado inteiramente em chips Huawei Ascend, o que sublinha a independência face ao hardware dos EUA.
DeepSeek V4: o concorrente chinês do GPT e do Claude
O setor aguarda com particular expectativa a próxima versão do modelo da DeepSeek. A geração anterior, DeepSeek V3, já tinha causado sensação por se aproximar do ChatGPT em muitos testes comparativos, com custos de treino bastante inferiores.
A futura versão V4 deverá destacar-se sobretudo em tarefas de programação. Segundo investigações de publicações especializadas, o DeepSeek V4 poderá superar os atuais modelos GPT da OpenAI e o Claude da Anthropic em determinados testes comparativos. Se isso se confirmar na prática, ficará disponível um assistente de programação chinês capaz de aliviar o trabalho de equipas de desenvolvimento em todo o mundo.
Kimi K2.5 da Moonshot AI: especialização em vez de gigantismo
Com o Kimi K2.5, a Moonshot AI segue uma abordagem também conhecida do Google Gemini 3.0: a «mistura de especialistas» (MoE). O grande modelo de linguagem é dividido em várias sub-redes especializadas. Para cada pedido, um mecanismo de encaminhamento decide quais as partes especializadas a ativar.
Esta estrutura poupa capacidade de processamento, pois o modelo completo não precisa de funcionar na máxima potência a cada pedido. Alguns especialistas concentram-se, por exemplo, na programação; outros dedicam-se à compreensão da linguagem, a tarefas matemáticas ou à escrita criativa.
- Vantagem: menor consumo de energia por pedido.
- Vantagem: possibilidade de otimizar especialistas individuais de forma direcionada.
- Risco: arquitetura mais complexa e mais difícil de depurar.
A diferença de desempenho diminui - e pode inverter-se
O ChatGPT, o Gemini e outros modelos norte-americanos ainda obtêm resultados ligeiramente melhores em muitos testes comparativos. Contudo, a vantagem encolheu e, muitas vezes, só é detetável numa análise aprofundada das tabelas de resultados. Para a utilização prática nas empresas, pesam outros fatores: custos, controlo, capacidade de adaptação e segurança jurídica.
Nas pequenas e médias empresas, um modelo apenas ligeiramente menos potente, que funcione localmente sem saída de dados, pode ser mais atrativo do que um serviço sofisticado na nuvem vindo da Califórnia.
Na Europa, onde as leis de proteção de dados são rigorosas, os modelos chineses de código aberto poderão preencher uma lacuna. As empresas descarregam os pesos, executam-nos em hardware próprio ou em fornecedores locais de alojamento e mantêm a informação sensível dentro da organização. Esta perspetiva altera o equilíbrio de forças no mercado mundial de IA.
O significado de «pesos abertos» e «IA de agentes»
Muitos termos associados aos novos modelos parecem técnicos, mas dizem respeito a aplicações muito concretas. «Pesos abertos» significa, por exemplo, que os pesos da rede treinada estão livremente disponíveis. Isso permite aos programadores:
- ajustar o modelo aos seus próprios dados;
- utilizá-lo em ambientes sem ligação, como redes isoladas;
- manter a independência face ao fornecedor original, desde que a licença o permita.
A «IA de agentes» designa sistemas que não se limitam a responder a perguntas: também planeiam e executam ações de forma autónoma, como pesquisar documentos, preencher formulários e acionar ferramentas externas. É precisamente nessa área que se inserem o Qwen3.5 e o GLM-5. A intenção é que sejam mais do que assistentes de conversação: devem trabalhar ativamente em segundo plano, desde a contabilidade ao desenvolvimento de software.
Oportunidades e riscos para a Alemanha e a região DACH
Para as empresas da região de língua alemã, esta evolução cria novas opções, mas também incerteza. Entre as oportunidades contam-se alternativas mais baratas aos serviços norte-americanos, maior diversidade tecnológica e a possibilidade de construir uma infraestrutura própria de IA sem depender inteiramente de um fornecedor.
Entre os riscos estão as tensões geopolíticas, eventuais restrições à exportação de software de IA e dúvidas jurídicas sobre responsabilidade, direitos de autor e utilização de dados. Quem adotar modelos chineses deve verificar cuidadosamente a licença aplicável e a forma como foram treinados.
Na prática, uma abordagem híbrida pode compensar para muitas empresas: executar aplicações críticas localmente com modelos de pesos abertos e continuar a recorrer a serviços na nuvem, como o ChatGPT, para casos de utilização criativos ou não sensíveis. Desta forma, o risco é distribuído e as equipas ganham experiência nos dois mundos, enquanto a distância entre a China e Silicon Valley continua a diminuir dia após dia.
Comentários
Ainda não há comentários. Seja o primeiro!
Deixar um comentário